
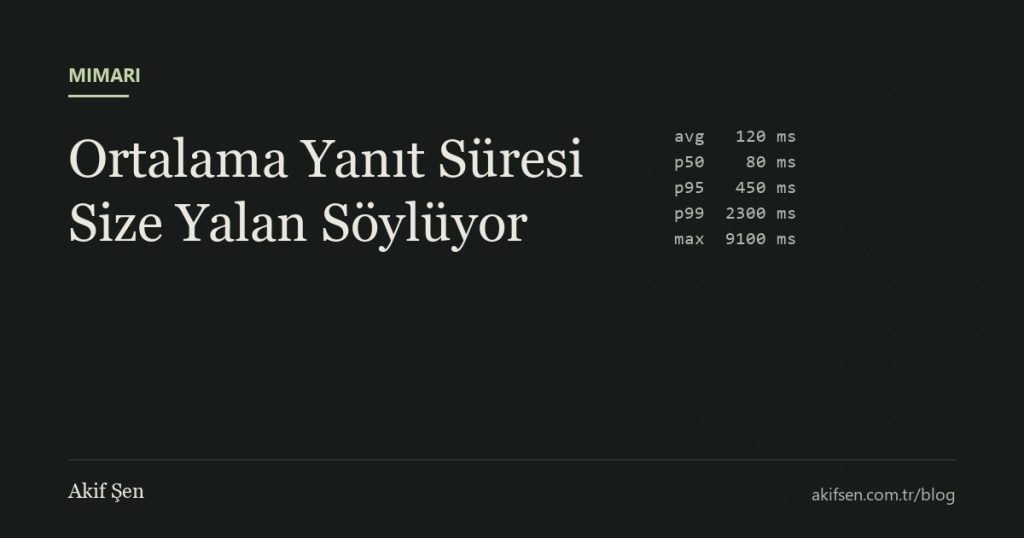
Bir dashboard’da şu değeri görüyorsunuz:
Ortalama yanıt süresi: 120 msGayet iyi.
Ama destek ekibine gelen şikayetler başka bir şey söylüyor. Kullanıcılar sayfanın bazen çok yavaş açıldığını, bazen hiç açılmadığını anlatıyor.
İkisi de doğru.
Ortalama dağılımı gizler
Yanıt süreleri neredeyse hiçbir zaman normal dağılmaz. İsteklerin çoğu hızlıdır. Küçük bir kısmı ise çok yavaştır.
100 istekten 98’i 50 ms, 2’si 3,5 saniye sürüyorsa ortalama yaklaşık 120 ms çıkar.
Bu ortalama, ne hızlı isteklerin ne de yavaş isteklerin deneyimini anlatır. Kimse gerçekten 120 ms beklememiştir.
Bu yüzden yanıt sürelerinde yüzdelik değerlere bakmak gerekir.
p50: İsteklerin yarısı bundan hızlı. Tipik deneyim.
p95, p99: İsteklerin yüzde 5’i veya yüzde 1’i bundan yavaş. Kötü deneyim.
Yüzde 1 az değildir
“Sadece yüzde 1’lik bir kısım yavaş” demek kolay.
Ama bir sayfa açılırken backend’e 20 farklı istek gidiyorsa, her isteğin yüzde 1 ihtimalle yavaş olması, sayfa yüklemelerinin yaklaşık yüzde 18’inin en az bir yavaş istek içermesi demektir.
1 - 0.99^20 ≈ 0.18Mikroservis mimarilerinde bu etki daha da büyür. Bir istek arka planda 10 servise dağılıyorsa, en yavaş servisin kuyruk gecikmesi toplam süreyi belirler.
Google’dan Jeffrey Dean ve Luiz Barroso’nun “The Tail at Scale” makalesi bu konuyu anlatan klasik kaynaklardan biri. Ölçek büyüdükçe nadir görülen gecikmelerin genel deneyimi belirlemeye başladığını gösteriyor.
Yüzdelikler toplanmaz
Bir başka sık yapılan hata: her sunucunun p99 değerini alıp ortalamasını hesaplamak.
Yüzdelik değerlerin ortalaması anlamlı değildir. Doğru p99 için ham ölçümlerin veya histogramların birleştirilmesi gerekir.
Prometheus’ta histogram metrikleri bu yüzden summary metriklerine tercih edilir. Histogram bucket’ları instance’lar arasında toplanabilir ve yüzdelik hesap birleştirilmiş veri üzerinden yapılır:
histogram_quantile(0.99,
  sum by (le) (rate(http_server_requests_seconds_bucket[5m])))
Yük testinde coordinated omission
Yük testlerinde sık rastlanan ve sonuçları sistematik olarak iyimser gösteren bir hata var.
Birçok yük testi aracı şöyle çalışır: bir istek gönderir, cevabı bekler, sonra bir sonraki isteği gönderir.
Sistem 5 saniyeliğine takıldığında, test aracı da o 5 saniye boyunca yeni istek göndermez. Sonuçta tek bir yavaş istek kaydedilir.
Gerçek dünyada ise kullanıcılar sistemin takılmasını beklemez. O 5 saniye içinde yüzlerce kullanıcı istek göndermiş ve hepsi beklemiştir.
Gil Tene bu probleme coordinated omission adını veriyor. Test aracı, sistemin yavaşladığı anlarda ölçüm yapmayı bıraktığı için en kötü anlar istatistiklerde neredeyse hiç görünmez.
Çözüm, isteklerin sabit bir hızda, cevapları beklemeden gönderilmesi ve gecikmenin isteğin gönderilmesi gereken andan itibaren ölçülmesidir. k6’nın arrival-rate executor’ları veya Gatling’in open model senaryoları bu şekilde çalışır.
Hedefi yüzdelikle koymak
Performans hedefleri de yüzdelik değerlerle tanımlanmalı:
p95 < 300 ms
p99 < 1 s
“Ortalama 200 ms altında olsun” gibi bir hedef, kuyruktaki problemleri görmezden gelmeye izin verir.
Bir de maksimum değere bakmak faydalı. Tek başına istatistiksel olarak anlamlı olmasa da, 30 saniyelik bir maksimum genellikle bir timeout’un, bir lock beklemesinin veya bir GC pause’unun izidir.
Kullanıcılar ortalama bir deneyim yaşamaz.
Ya hızlı bir sayfa görürler ya da yavaş bir sayfa. Ölçümlerimiz de bu ayrımı göstermeli.