
Bir endpoint yavaş. Ülke listesi, kategori ağacı ve uygulama ayarları her istekte veritabanından okunuyor.
Cache eklemeye karar veriliyor. İlk akla gelen Redis.
Ama bu veriler nadiren değişiyor, küçük ve her instance’ta aynı. Her istek için Redis’e bir network çağrısı yapmak gerçekten gerekli mi?
Local cache
Local cache, verinin uygulamanın kendi belleğinde tutulmasıdır. Network yok, serialization yok.
Redis’ten bir değer okumak genellikle bir milisaniye civarında sürer. Local cache’ten okumak ise nanosaniyeler seviyesinde.
Saniyede binlerce kez okunan küçük veriler için bu fark ciddi. Ayrıca Redis’e olan yük ve bağımlılık da azalır. Redis kısa süreliğine erişilemez olsa bile, local cache’teki veriler sunulmaya devam eder.
Caffeine
Java’da local cache için en yaygın tercih Caffeine. Guava cache’in yazarı tarafından geliştirildi ve yüksek performanslı bir tahliye algoritması kullanıyor.
Cache<String, Category> cache = Caffeine.newBuilder()
    .maximumSize(10_000)
    .expireAfterWrite(Duration.ofMinutes(10))
    .recordStats()
    .build();
maximumSize önemli. Sınırsız bir local cache, bellek sızıntısının en kolay yoludur.
Spring Boot’ta spring-boot-starter-cache ve Caffeine birlikte kullanıldığında, @Cacheable anotasyonu doğrudan Caffeine üzerinde çalışır.
Tutarlılık problemi
Local cache’in büyük dezavantajı, her instance’ın kendi kopyasına sahip olması.
Bir yönetici bir kategorinin adını değiştirdi. İsteği işleyen instance kendi cache’ini temizledi. Ama diğer dört instance hâlâ eski adı gösteriyor. TTL dolana kadar.
Bu problemle başa çıkmanın birkaç yolu var.
Kısa TTL. Birkaç dakikalık tutarsızlık kabul edilebilirse en basit çözüm. Ülke listesi, ayarlar ve kategori ağacı gibi veriler için genellikle yeterli.
Invalidation mesajı. Veri değiştiğinde bir mesaj yayınlanır. Redis Pub/Sub veya bir mesaj kuyruğu üzerinden bütün instance’lar bu mesajı alır ve ilgili anahtarı kendi cache’lerinden siler.
Mesaj kaybolursa bazı instance’lar eski veriyi tutmaya devam eder. Bu yüzden invalidation mesajı ile birlikte bir TTL kullanmak, en kötü durumda bile tutarsızlığın süresini sınırlar.
İki katmanlı cache
Bazı sistemler iki katmanı birlikte kullanır.
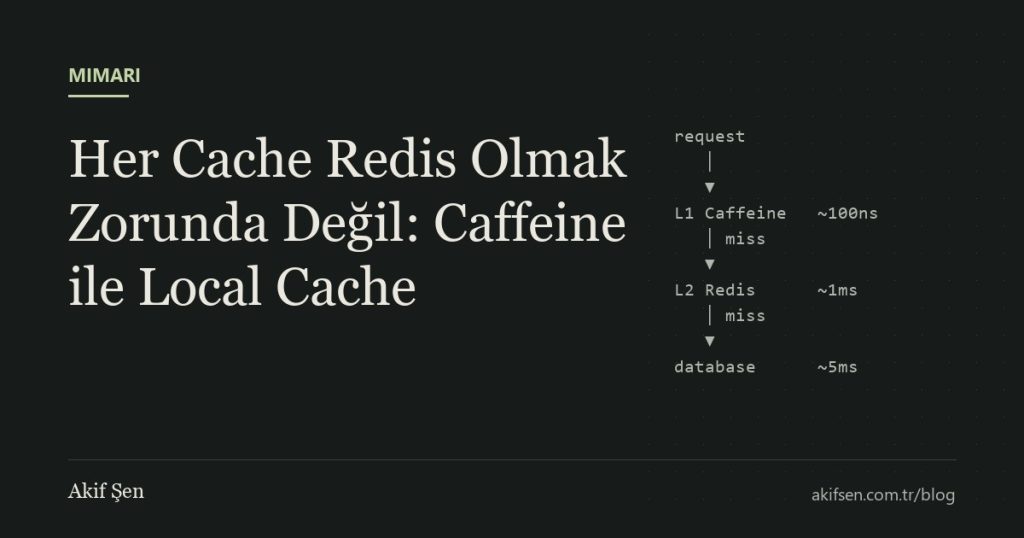
Önce local cache’e bakılır. Yoksa Redis’e. Orada da yoksa veritabanına.
Sık okunan ve nadiren değişen veriler local cache’ten hızlıca gelir. Redis, instance’lar arasında paylaşılan ve daha büyük veri setleri için ikinci bir katman sağlar. Yeni başlayan bir instance, soğuk cache ile veritabanını yormak yerine Redis’ten ısınır.
Bedeli karmaşıklık. İki katman, iki farklı invalidation stratejisi ve hata ayıklarken “bu veri nereden geldi?” sorusu.
Neyi local cache’lemeli?
Benim kullandığım kriterler:
- Küçük boyutlu
- Sık okunan
- Nadiren değişen
- Kısa süreli tutarsızlığın sorun olmadığı
Referans veriler, konfigürasyonlar, yetki tanımları, şablonlar bu kategoriye uyuyor.
Kullanıcıya özel veriler, sık değişen veriler ve tutarlılığın kritik olduğu veriler, örneğin stok veya bakiye, için local cache uygun değil.
Bellek bütçesi
Local cache, uygulamanın heap’ini kullanır. Container bellek limitleri düşünülürken bu da hesaba katılmalı. Büyük bir local cache, GC süresini de uzatabilir.
recordStats() ile hit oranını, boyutu ve tahliye sayısını izlemek, cache’in gerçekten işe yarayıp yaramadığını gösterir. Düşük hit oranı, ya yanlış veri cache’leniyor ya da boyut yetersiz demektir.
Redis güçlü bir araç ve birçok senaryoda doğru seçim.
Ama her cache ihtiyacı için varsayılan olarak Redis’e gitmek, bazen milisaniyeler süren bir çağrıyı, nanosaniyeler süren bir bellek okumasının yerine koymak demek.