
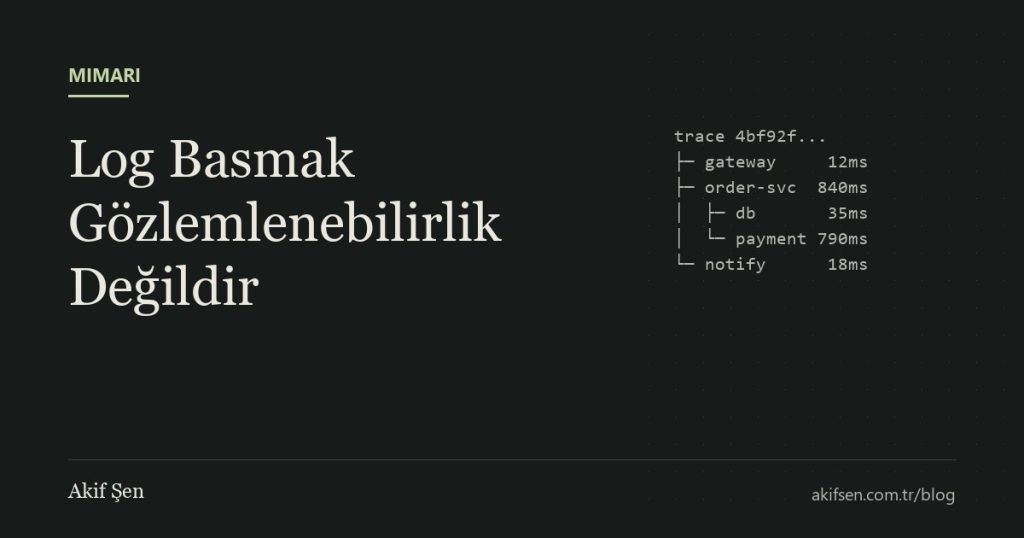
Bir incident sırasında yaşanan tipik sahne:
Bir müşteri ödeme ekranının çok yavaş olduğunu söylüyor.
Log sistemini açıyorsunuz.
Son bir saatte 4 milyon satır log var.
Hangisinin o müşteriye ait olduğunu bilmiyorsunuz.
Bulsanız bile isteğin hangi servislerden geçtiğini ve zamanın nerede harcandığını görmek için beş farklı servisin loglarını zaman damgasıyla elle eşleştirmeye çalışıyorsunuz.
Sistem log üretiyor. Ama gözlemlenebilir değil.
Üç sinyal, üç farklı soru
Log, metric ve trace genellikle aynı cümlede anılır ama farklı soruları cevaplar.
Metric: Bir şeyler ters gidiyor mu? Hata oranı, latency yüzdelikleri, kuyruk uzunluğu. Ucuzdur, uzun süre saklanabilir, alarm kurmak için idealdir.
Trace: Ters giden şey nerede? Tek bir isteğin servisler arasındaki yolculuğunu ve her adımın süresini gösterir.
Log: Tam olarak ne oldu? Belirli bir anın detayını, hata mesajını, iş bağlamını anlatır.
Sağlıklı bir inceleme genellikle bu sırayla ilerler. Metric problemi gösterir, trace yerini daraltır, log nedenini açıklar.
Sadece log ile başlamak samanlıkta iğne aramaktır.
Correlation ID her şeyi bağlar
Bu üç sinyali birbirine bağlayan şey ortak bir kimliktir.
W3C Trace Context standardı bunun için traceparent header’ını tanımlıyor:
traceparent: 00-4bf92f3577b34da6a3ce929d0e0e4736-00f067aa0ba902b7-01Gateway’e gelen her istek bir trace ID alır. Bu ID her servis çağrısında, her mesaj kuyruğu event’inde taşınır. Loglara da yazılır.
İncident anında yavaş bir trace bulduğunuzda, aynı trace ID ile o isteğe ait bütün logları tek sorguda görebilirsiniz.
Asenkron akışlarda bu bağlam en kolay kaybolan şeydir. Kafka veya RabbitMQ mesajlarının header’ına trace context eklenmezse, trace kuyruğun önünde biter.
Structured logging
Şu log satırı insan için okunabilir:
Payment failed for order 1842 after 3 retriesAma makine için okunamaz. “Son bir saatte 3 retry sonrası başarısız olan ödemeler” gibi bir sorgu yazmak zordur.
Aynı bilgi structured olarak şöyle yazılabilir:
{
  "level": "warn",
  "event": "payment_failed",
  "orderId": 1842,
  "retries": 3,
  "provider": "bank-x",
  "traceId": "4bf92f35..."
}
Mesaj kısa ve sabittir. Değişken bilgiler alanlarda durur. Filtreleme, gruplama ve dashboard oluşturma artık mümkündür.
Ne kadar log?
Daha fazla log daha fazla görünürlük demek değildir.
Her metot girişinde ve çıkışında log basan bir sistemde önemli satırlar gürültü içinde kaybolur. Üstelik log saklama maliyeti bir noktadan sonra altyapı faturasının ciddi bir kalemi haline gelir.
Kendime sorduğum soru şu: bu log satırını bir incident sırasında okursam karar vermeme yardım eder mi?
Etmiyorsa ya silinmeli ya da debug seviyesine indirilmeli.
Kardinalite tuzağı
Metric tarafında en sık yapılan hata, label olarak yüksek kardinaliteli değerler kullanmaktır:
http_requests_total{userId="42"}Her kullanıcı için ayrı bir time series oluşur. Bir milyon kullanıcı, bir milyon seri demektir. Prometheus gibi sistemler bu yükü taşıyamaz.
User ID, order ID gibi değerler trace ve log’a aittir. Metric’lerde endpoint, status code ve servis adı gibi sınırlı değerler kullanılmalıdır.
OpenTelemetry
Bugün bu üç sinyali tek bir standart altında toplamak için en yaygın tercih OpenTelemetry. Instrumentation kodunu belirli bir vendor’a bağlamadan yazmanızı sağlıyor. Backend olarak Jaeger, Tempo, Datadog veya başka bir şey seçmek sonradan verilebilecek bir karar haline geliyor.
Java tarafında agent ile başlamak çoğu framework için otomatik instrumentation sağlıyor. Sonra iş açısından önemli noktalara manuel span eklemek yeterli oluyor.
Gözlemlenebilirlik production’a çıktıktan sonra eklenen bir özellik değil.
Sistemi tasarlarken sorulması gereken bir soru:
Bu sistem bozulduğunda, nedenini kodu açmadan anlayabilecek miyim?