
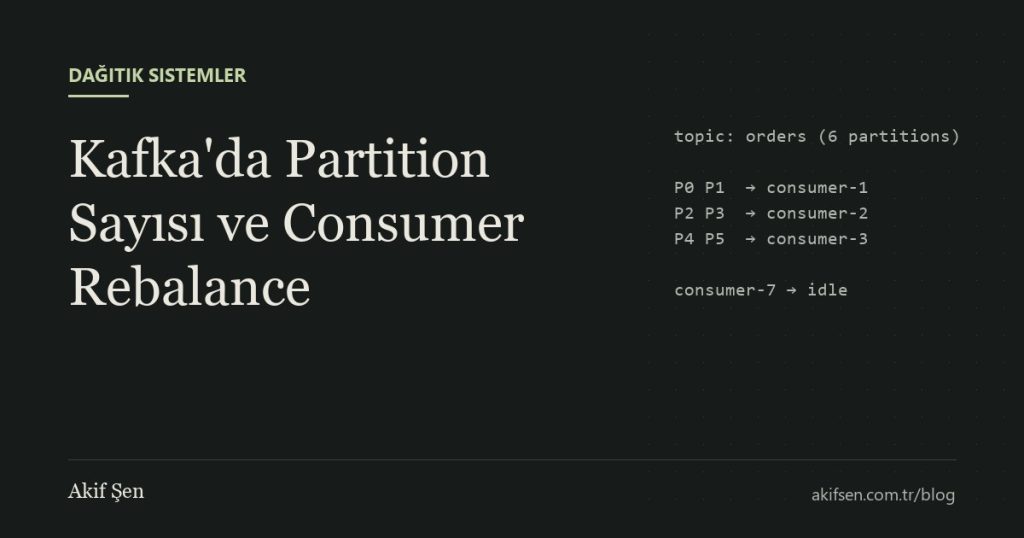
Kafka consumer’ı yavaş kalmaya başladı. Lag sürekli artıyor.
Çözüm basit görünüyor: daha fazla consumer instance.
3’ten 10’a çıkarıyorsunuz.
Lag aynı hızla artmaya devam ediyor. Yeni instance’ların yarısı hiçbir şey yapmıyor.
Paralellik partition sayısıyla sınırlı
Kafka’da bir consumer group içinde her partition aynı anda sadece bir consumer tarafından okunur.
Topic’in 6 partition’ı varsa, aynı group içinde en fazla 6 consumer aktif çalışabilir. Yedinci consumer boşta bekler.
Bu bir sınırlama gibi görünse de aslında Kafka’nın sıralama garantisinin kaynağı. Bir partition içindeki mesajlar sırayla, tek bir consumer tarafından işlenir.
Partition sayısı topic oluşturulurken belirlenir. Artırılabilir ama azaltılamaz. Ve artırıldığında, key bazlı dağıtım değişir. Aynı key’e sahip mesajlar artık farklı bir partition’a gidebilir ve sıralama geçiş anında bozulabilir.
Bu yüzden partition sayısını baştan, beklenen en yüksek paralelliği düşünerek seçmek gerekir. Çok fazla partition ise broker tarafında ek yük ve daha uzun rebalance süreleri demek. İkisi arasında bir denge kurulmalı.
Partition key
Producer mesajı gönderirken bir key verirse, aynı key’e sahip mesajlar her zaman aynı partition’a gider:
producer.send(new ProducerRecord<>("orders", orderId, event));Aynı siparişe ait bütün event’ler sırayla işlenir.
Key seçimi dağılımı da belirler. Az sayıda farklı değeri olan bir key, örneğin ülke kodu, mesajların birkaç partition’da yığılmasına yol açar. Trafiğin yarısı tek bir ülkeden geliyorsa, o ülkenin partition’ını işleyen consumer darboğaz olur. Diğerleri boşta kalır.
Key, hem sıralamanın gerektiği birimi hem de yeterince dağılmış değerleri temsil etmeli.
Rebalance
Bir consumer group’a consumer eklendiğinde, çıktığında veya bir consumer zamanında heartbeat göndermediğinde, partition’lar yeniden dağıtılır.
Klasik rebalance protokolünde bu sırada bütün consumer’lar partition’larını bırakır ve yeni dağıtım bitene kadar işlem yapmaz. Rolling deploy sırasında her instance yeniden başladığında bu tekrarlanır. Sonuç, deploy boyunca tekrar eden kısa duraklamalardır.
Cooperative rebalancing bu etkiyi azaltır. Sadece el değiştirmesi gereken partition’lar bırakılır, diğerleri işlenmeye devam eder. Kafka’nın yeni consumer group protokolü de rebalance mantığını broker tarafına taşıyarak bu süreci daha da iyileştiriyor.
Static membership ise kısa süreli yeniden başlatmalarda rebalance’ı tamamen önleyebilir. Her consumer’a sabit bir group.instance.id verildiğinde, broker kısa bir süre o consumer’ın geri dönmesini bekler.
max.poll.interval.ms
Sık karşılaşılan bir başka problem, mesaj işleme süresinin uzaması nedeniyle consumer’ın gruptan atılmasıdır.
Consumer poll() çağrıları arasında max.poll.interval.ms süresini aşarsa, Kafka onu ölü kabul eder ve partition’larını başkasına verir. Varsayılan değer 5 dakika.
Bir batch içinde 500 mesaj alınıyor ve her biri yavaş bir dış servise gidiyorsa, bu süre aşılabilir. Consumer atılır, mesajlar commit edilmemiştir, başka bir consumer aynı mesajları tekrar işler. Yine yavaş kalır ve o da atılır.
Döngüden çıkmak için max.poll.records değerini düşürmek veya işleme süresini kısaltmak gerekir.
Kafka’da ölçeklenme, instance sayısını artırmakla başlamaz.
Partition’ların nasıl bölündüğünü ve mesajların bunlara nasıl dağıldığını anlamakla başlar.