
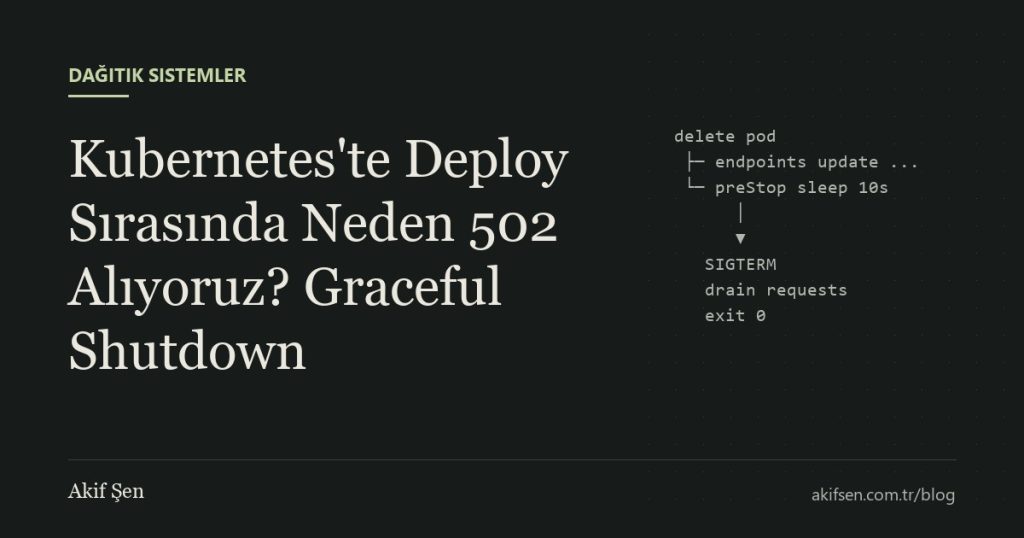
Rolling update ile deploy yapıyoruz.
Yeni pod’lar ayağa kalkıyor, eskiler kapanıyor. Teoride hiçbir istek kaybolmamalı.
Ama monitoring ekranında her deploy sırasında küçük bir 502 ve 503 sıçraması görünüyor.
Birkaç istek. Birkaç saniye.
Çoğu ekip bunu kabul edip geçiyor. Ama bu istekler bir ödeme çağrısıysa, “birkaç istek” küçük bir problem değil.
Kapanma sırası paralel ilerler
Kubernetes bir pod’u sonlandırmaya karar verdiğinde iki şey neredeyse aynı anda olur:
Pod’a SIGTERM sinyali gönderilir.
Pod, Service’in endpoint listesinden çıkarılır.
Sorun şu ki ikincisi anlık değildir. Endpoint değişikliğinin kube-proxy’lere, ingress controller’a ve service mesh’e yayılması zaman alır. Birkaç saniye boyunca bu bileşenler trafiği hâlâ kapanmakta olan pod’a gönderebilir.
Uygulama SIGTERM’i alır almaz kapanırsa, bu süre içinde gelen istekler kapalı bir porta denk gelir.
preStop ile beklemek
Bu yarışı önlemenin en yaygın yolu, SIGTERM’den önce kısa bir bekleme koymaktır:
lifecycle:
  preStop:
    exec:
      command: ["sleep", "10"]
Kubernetes önce preStop hook’unu çalıştırır, o bitince SIGTERM gönderir. Bu 10 saniye boyunca uygulama normal şekilde istek almaya devam eder, bu arada da endpoint değişikliği bütün bileşenlere yayılır.
Kulağa biraz hack gibi geliyor. Ama Kubernetes’in mevcut tasarımında bu yaklaşım oldukça standart. Yeni Kubernetes sürümlerinde sleep için container image’ına ihtiyaç duymayan yerleşik bir preStop aksiyonu da bulunuyor.
Graceful shutdown
SIGTERM geldiğinde uygulamanın yapması gereken şey yeni istek kabul etmeyi bırakmak ve devam eden istekleri tamamlamaktır.
Spring Boot’ta bu tek satır:
server.shutdown=graceful
spring.lifecycle.timeout-per-shutdown-phase=20s
Uygulama yeni bağlantıları reddeder, mevcut istekler en fazla 20 saniye içinde tamamlanır.
Ama HTTP istekleri tek iş değildir. Kafka consumer’ları, işlenmekte olan kuyruk mesajları ve arka plan işleri de düzgün şekilde durdurulmalı. Yarıda kalan bir mesaj, commit edilmediyse başka bir instance tarafından yeniden işlenir. Bu da idempotency’nin neden her yerde önemli olduğunun bir başka örneği.
Süreler birbirine uymalı
Burada birkaç değer birbiriyle tutarlı olmalı:
preStop sleep              10s
graceful shutdown timeout  20s
terminationGracePeriod     40s
terminationGracePeriodSeconds toplam süredir ve preStop beklemesini de kapsar. Varsayılan değeri 30 saniyedir. preStop ve graceful shutdown süresinin toplamı bunu aşarsa Kubernetes SIGKILL gönderir ve uygulama ne yapıyorsa yarıda kalır.
Readiness ve liveness farklı sorular sorar
Deploy problemlerinin bir kısmı da yeni pod’un trafiğe çok erken açılmasından kaynaklanır.
Readiness probe şunu sorar: bu pod şu anda trafik almaya hazır mı?
Liveness probe ise şunu sorar: bu pod kurtarılamaz bir durumda mı, yeniden başlatılmalı mı?
Spring Boot Actuator bu ikisini ayrı endpoint’ler olarak sunuyor:
/actuator/health/readiness
/actuator/health/liveness
Sık yapılan bir hata, liveness probe’a veritabanı kontrolü eklemektir. Veritabanı kısa süreliğine erişilemez olduğunda bütün pod’lar aynı anda yeniden başlatılır. Bu da veritabanı geri geldiğinde üzerine soğuk başlayan onlarca pod’un yüklenmesi anlamına gelir.
Dış bağımlılıklar liveness’ta değil, gerekiyorsa readiness’ta kontrol edilmelidir. Liveness sadece uygulamanın kendisinin kilitlenip kilitlenmediğini söylemeli.
JVM uygulamaları için bir de startup süresi var. Uygulama ayağa kalkarken liveness probe’un erken başarısız olmasını önlemek için startupProbe tanımlamak, uzun initial delay değerleriyle uğraşmaktan daha temiz bir çözüm.
Test etmek
Bu ayarların doğru olup olmadığını anlamanın en iyi yolu, deploy sırasında sürekli trafik gönderen basit bir yük testi çalıştırmaktır.
Deploy boyunca tek bir hata bile görünüyorsa, kapanma sırasında bir şey eksik demektir.
Kesintisiz deploy, platformun bize hazır verdiği bir özellik değil.
Uygulamanın kapanmayı bilmesiyle elde edilen bir sonuç.