
Bir kuyruk tüketicisi düşünün.
Mesajı alır, işler, onaylar.
Bir gün kuyruğa bozuk bir mesaj gelir. Belki zorunlu bir alan boştur. Belki referans verdiği müşteri silinmiştir.
Consumer exception fırlatır.
Mesaj onaylanmadığı için kuyruğa geri döner.
Consumer onu tekrar alır. Tekrar hata verir. Tekrar kuyruğa döner.
Saniyede yüzlerce kez.
Arkasında bekleyen binlerce sağlıklı mesaj ise hiç işlenmez.
Poison message
Bu tür mesajlara poison message deniyor. Ne kadar tekrar denenirse denensin başarılı olamayacak mesajlar.
Problem tek mesajın işlenememesi değil. O mesajın bütün kuyruğu kilitlemesi.
Özellikle sıralı işlenen kuyruklarda, örneğin bir Kafka partition’ında, consumer bozuk mesajı geçemediği sürece arkasındaki hiçbir mesaja ulaşamaz. Consumer lag dakikalar içinde büyür.
Geçici ve kalıcı hata ayrımı
Her hata aynı değildir.
Veritabanına kısa süreli erişilememesi geçici bir hatadır. Birkaç saniye sonra tekrar denemek muhtemelen başarılı olur.
Mesajın JSON formatının bozuk olması kalıcı bir hatadır. Bin kez denense de sonuç değişmez.
Consumer’ın ilk görevi bu ayrımı yapmaktır:
catch (TransientDataAccessException e) {
    // tekrar dene
}
catch (JsonParseException | ValidationException e) {
    // tekrar deneme, doğrudan DLQ
}
Kalıcı hataları retry etmek sadece kaynak harcar.
Retry’ı ana kuyruktan ayırmak
Geçici hatalar için retry gerekli. Ama retry’ı ana kuyruğu bloklamadan yapmak gerekir.
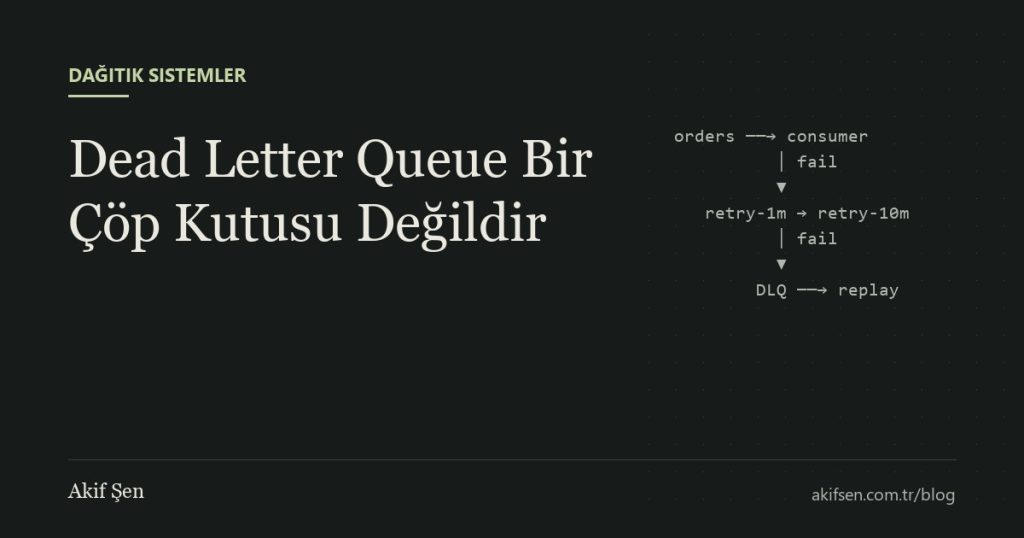
Yaygın bir yöntem, gecikmeli retry kuyrukları kullanmak:
orders
orders.retry.1m
orders.retry.10m
orders.dlq
İlk hata alan mesaj 1 dakikalık retry kuyruğuna gider. Orada da başarısız olursa 10 dakikalık kuyruğa. Hâlâ başarısızsa dead letter queue’ya.
Ana kuyruk akmaya devam eder. Problemli mesaj bir kenarda, kendi temposunda tekrar denenir.
Spring Kafka’nın @RetryableTopic desteği bu yapıyı birkaç satır konfigürasyonla kuruyor. RabbitMQ tarafında dead letter exchange ve TTL kombinasyonu ile benzer bir yapı oluşturulabiliyor.
Ama bir bedeli var: retry kuyruğu kullanıldığında mesajların sırası bozulur. Aynı siparişe ait iki event varsa ve ilki retry kuyruğuna gittiyse, ikincisi ondan önce işlenebilir. Sıralama önemliyse bu ayrıca düşünülmeli.
DLQ’ya mesaj atmak işin yarısı
Birçok sistemde DLQ şöyle çalışır: başarısız mesajlar oraya gider ve bir daha kimse onlara bakmaz.
Birkaç ay sonra DLQ’da 40 bin mesaj vardır ve hiç kimse bunların ne olduğunu bilmez.
Bu bir dead letter queue değil, sessizce veri kaybetmenin daha düzenli bir yoludur.
Bence bir DLQ’nun faydalı olması için üç şey gerekiyor.
Bağlam. Mesajla birlikte hata mesajı, exception tipi, kaç kez denendiği, hangi consumer’ın ve hangi versiyonun hata verdiği saklanmalı. Header’lar bunun için uygun.
Görünürlük. DLQ’ya mesaj düştüğünde bir alarm çalmalı. DLQ boyutu bir metrik olarak izlenmeli. Sıfırdan farklı bir DLQ, bir şeyin ters gittiğini söyler.
Replay. Hata giderildikten sonra mesajları ana kuyruğa geri gönderebilecek bir araç olmalı. Bug düzeltildi, deploy edildi, DLQ’daki 300 mesaj tekrar işlendi. Bu akış önceden düşünülmezse, ilk ihtiyaç anında elle script yazılır.
Replay güvenli olmalı
DLQ’daki mesajları tekrar oynatmak, bazılarının ikinci kez işlenmesi anlamına gelebilir. Mesaj kısmen işlenmiş ve sonra hata vermiş olabilir.
Bu yüzden consumer’ın idempotent olması burada da önemli. Aynı event ID ile gelen ikinci mesaj, yan etki oluşturmadan atlanabilmeli.
Mesajlaşma sistemleri genellikle mutlu yol üzerinden tasarlanır.
Ama bir sistemin olgunluğu, işlenemeyen mesajlara ne olduğuna bakılarak daha iyi anlaşılır.