
Yeni bir tablo oluştururken primary key genellikle düşünülmeden seçilir.
id BIGSERIAL PRIMARY KEYveya
id UUID PRIMARY KEY DEFAULT gen_random_uuid()İkisi de çalışır. Ama ikisi de sistem büyüdükçe farklı problemler çıkarır.
Auto increment’in sorunu
Sıralı bir sayı küçüktür, hızlıdır, okunması kolaydır. B-tree index’e her zaman sondan eklenir.
Problemi dışarıya açıldığında başlar.
GET /api/invoices/10432Bu URL’yi gören biri 10431’i denemek ister. Yetki kontrolü doğru yapılmışsa sorun yoktur. Ama bir endpoint’te kontrol unutulduysa, bütün kayıtlar sırayla okunabilir.
Sıralı ID ayrıca iş bilgisi sızdırır. Bugün 10432 numaralı sipariş, yarın 10619 ise, rakibiniz günlük sipariş sayınızı kolayca hesaplar.
Bir de dağıtık sistemler meselesi var. ID’yi veritabanı ürettiği için kaydı oluşturmadan ID bilinmez. Birden fazla veritabanını birleştirmek gerektiğinde çakışmalar başlar.
Rastgele UUID’nin sorunu
UUIDv4 bu problemlerin hepsini çözer. Tahmin edilemez, her yerde üretilebilir, çakışma ihtimali pratikte sıfırdır.
Ama rastgele olması index için kötü bir haberdir.
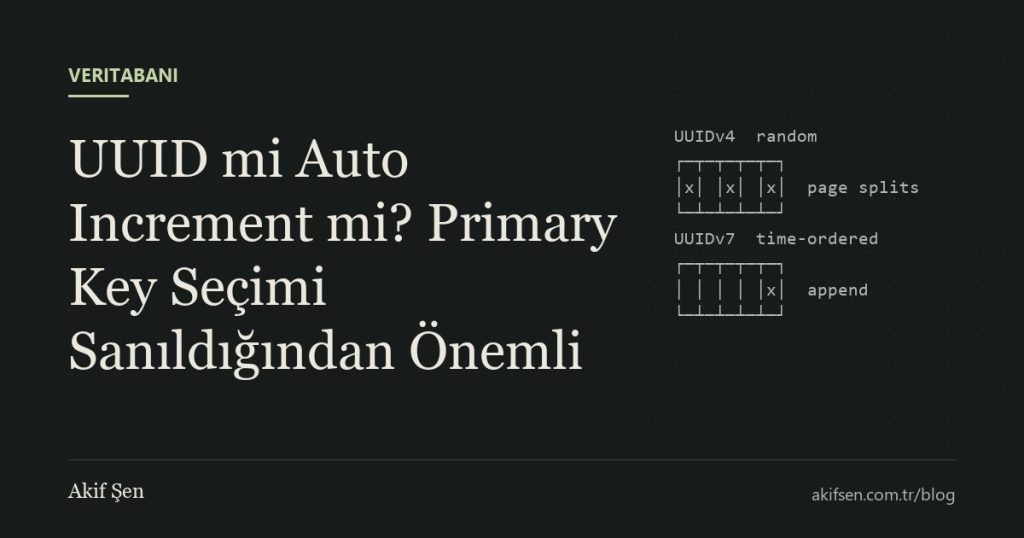
Her yeni kayıt B-tree’nin rastgele bir yerine yerleşir. Index sayfaları sürekli bölünür, doluluk oranı düşer, sıcak sayfalar bellekte tutulamaz. Tablo büyüdükçe insert performansı belirgin şekilde düşer. Yazma yoğun tablolarda bu fark ciddi boyutlara ulaşabiliyor.
16 byte’lık bir anahtar, 8 byte’lık bir bigint’e göre her index’te ve her foreign key’de iki kat yer kaplar.
UUIDv7
RFC 9562 ile standartlaşan UUIDv7, ilk 48 bitinde milisaniye cinsinden zaman damgası taşır. Geri kalanı rastgeledir.
0192c8a4-7f3e-7b21-9a4c-3e8f12d6a0b5
└── timestamp ──┘
Zaman sıralı olduğu için yeni kayıtlar index’in sonuna yakın bir yere eklenir. Auto increment’e yakın bir insert davranışı elde edilir. Ama yine her yerde üretilebilir ve tahmin edilmesi zordur.
PostgreSQL 18 ile uuidv7() fonksiyonu yerleşik geldi. Daha eski sürümlerde uygulama tarafında üretmek de kolay. Java’da birkaç küçük kütüphane bunu tek satırla sağlıyor.
Bir uyarı: UUIDv7 oluşturulma zamanını açığa çıkarır. Kaydın ne zaman oluşturulduğu hassas bir bilgiyse bunu hesaba katmak gerekir.
İki ID kullanmak
Bazı sistemler içeride bigint, dışarıda ayrı bir public ID kullanır:
id         BIGINT   -- join ve foreign key için
public_id  UUID     -- API ve URL için
İçeride küçük ve hızlı anahtarlar, dışarıda tahmin edilemeyen kimlikler. Bedeli her tabloda ek bir unique index ve iki ID arasında dönüşüm disiplini.
Benim tercihim
Yeni projelerde çoğunlukla UUIDv7 kullanıyorum. Tek bir kimlik hem içeride hem dışarıda iş görüyor, index davranışı makul ve kayıtlar oluşturulmadan önce ID bilinebiliyor. Bu son madde özellikle outbox ve event tabanlı akışlarda işleri kolaylaştırıyor.
Çok yüksek yazma hacmi ve çok büyük tablolar varsa, bigint’in sağladığı alan tasarrufu hâlâ anlamlı olabilir.
Primary key bir kez seçilir ve neredeyse hiç değiştirilmez. Bu yüzden ilk günden üzerinde birkaç dakika düşünmeye değer.