
Şu kod incelemede muhtemelen hiç dikkat çekmez:
List<Order> orders = orderRepository.findRecent();

return orders.stream()
    .map(o -> new OrderDto(
        o.getId(),
        o.getCustomer().getName(),
        o.getTotal()))
    .toList();
Okunaklı. Kısa. Doğru sonuç döndürüyor.
Ama arka planda şunlar oluyor:
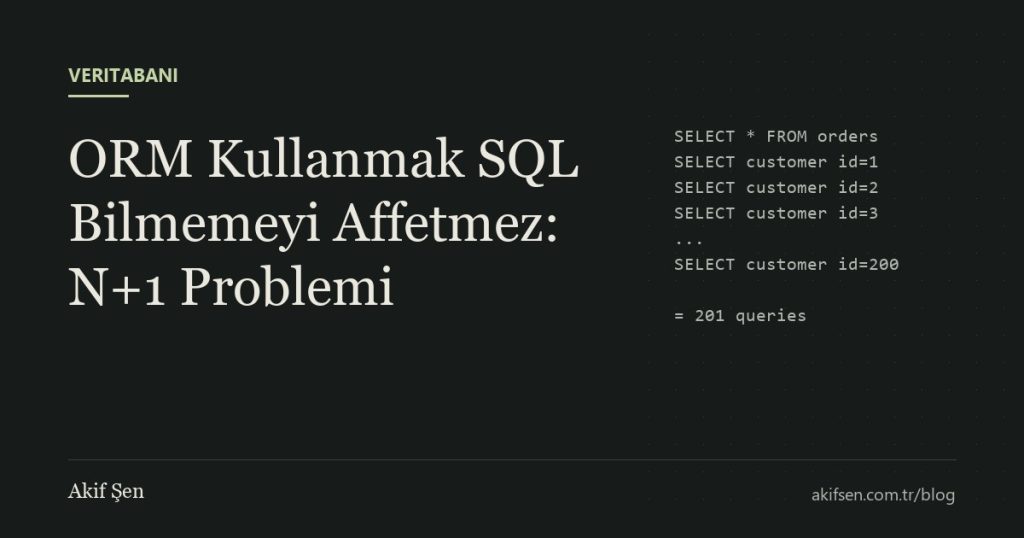
SELECT * FROM orders ORDER BY created_at DESC LIMIT 200;
SELECT * FROM customers WHERE id = ?;
SELECT * FROM customers WHERE id = ?;
...
Bir sorgu siparişleri getiriyor. Sonra her sipariş için müşteriyi getiren ayrı bir sorgu çalışıyor.
200 sipariş için 201 sorgu.
Neden fark edilmiyor?
Geliştirici ortamında veritabanı aynı makinede çalışır. Her sorgu 0.3 ms sürer. 201 sorgu 60 ms eder.
Kimse şikayet etmez.
Production’da veritabanı ayrı bir makinededir. Her sorgunun network round-trip maliyeti 1-2 ms olur. Aynı endpoint artık 400 ms sürer. Trafik arttığında connection pool bu sorgularla dolar.
Üstelik kod tarafında hiçbir şey değişmemiştir. Problem verinin büyümesiyle kendiliğinden ortaya çıkar.
Lazy loading
Problemin kaynağı lazy loading’dir.
@ManyToOne ilişkisi lazy tanımlandığında Hibernate müşteri nesnesinin yerine bir proxy koyar. getCustomer().getName() çağrıldığı anda proxy veritabanına gider.
Bu davranış kendi başına kötü değil. İlişkili veri her zaman gerekmiyorsa yüklenmemesi mantıklı.
Sorun, verinin bir döngü içinde tek tek istenmesidir.
Bu arada JPA’da @ManyToOne ilişkisinin varsayılanı eager’dır. Eager loading N+1’i çözmez, sadece her yere taşır. Bu yüzden genel tavsiye ilişkileri lazy tanımlamak ve ihtiyaç olan yerde açıkça yüklemektir.
Fetch join
İhtiyaç belliyse veri tek sorguda istenebilir:
@Query("""
    select o from Order o
    join fetch o.customer
    order by o.createdAt desc
    """)
List<Order> findRecentWithCustomer(Pageable page);
201 sorgu yerine tek bir join.
Aynı sonucu @EntityGraph ile de almak mümkün:
@EntityGraph(attributePaths = "customer")
List<Order> findTop200ByOrderByCreatedAtDesc();
Collection fetch ve pagination
Fetch join’in bir tuzağı var.
@OneToMany bir collection’ı fetch join ile yükleyip aynı anda pagination yapmaya çalıştığınızda Hibernate şu uyarıyı verir:
HHH90003004: firstResult/maxResults specified
with collection fetch; applying in memory
Yani sorgu tüm sonuçları belleğe çeker ve sayfalamayı uygulama içinde yapar. Küçük tabloda fark edilmez, büyük tabloda OutOfMemoryError getirebilir.
Bu durumda iki aşamalı yaklaşım daha güvenlidir: önce sayfalanmış ID’leri getir, sonra o ID’ler için ilişkileri yükle. Hibernate’in @BatchSize anotasyonu da lazy collection’ları tek tek değil, gruplar halinde yükleyerek sorgu sayısını ciddi şekilde azaltır.
DTO projection
Bazen entity yüklemeye hiç gerek yoktur.
Sadece sipariş ID’si, müşteri adı ve toplam tutar gösterilecekse:
select new com.example.OrderSummary(
    o.id, c.name, o.total)
from Order o join o.customer c
Sadece gereken kolonlar okunur. Persistence context’e entity eklenmez. Dirty checking maliyeti oluşmaz.
Okuma ağırlıklı endpoint’lerde, özellikle listelerde, projection genellikle en verimli seçenektir.
Tespit etmek
N+1’i code review ile yakalamak zordur. Ölçmek gerekir.
Geliştirme ortamında SQL loglarını açmak ilk adımdır. Ama asıl etkili yöntem test içinde sorgu sayısını doğrulamaktır. Hibernate statistics veya datasource-proxy gibi bir araçla şöyle bir assertion yazılabilir:
assertThat(queryCount).isLessThanOrEqualTo(2);Biri ileride DTO’ya yeni bir lazy alan eklediğinde test kırılır.
ORM’ler veritabanı erişimini kolaylaştırıyor.
Ama veritabanına kaç kez gittiğimizi gizlemeleri, en pahalı hatalarımızın bazılarını da görünmez yapıyor.