
Çoğu backend geliştiricisi için transaction şu anlama gelir:
Ya hepsi olur ya hiçbiri.
Bu doğru. Atomiklik transaction’ın en bilinen özelliği.
Ama transaction’ın daha az konuşulan bir yanı var: aynı anda çalışan diğer transaction’ları ne kadar gördüğü.
Bunu isolation seviyesi belirler ve çoğu uygulama hangi seviyede çalıştığını bilmeden çalışır.
Varsayılan değer
PostgreSQL, SQL Server ve Oracle’da varsayılan seviye READ COMMITTED. MySQL InnoDB’de ise REPEATABLE READ.
Yani aynı kod, farklı veritabanlarında farklı eşzamanlılık davranışı gösterebilir.
Read committed neyi garanti eder?
Read committed tek bir şey söz verir: commit edilmemiş veriyi görmezsiniz.
Başka bir transaction’ın yarıda kalmış değişikliklerini okumazsınız. Bu iyi.
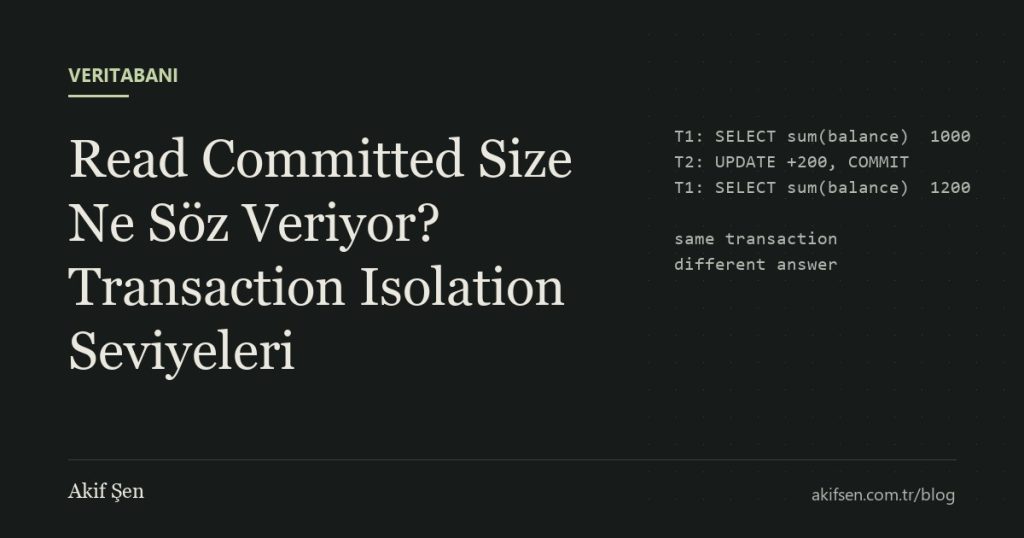
Ama aynı transaction içinde aynı sorguyu iki kez çalıştırırsanız farklı sonuç alabilirsiniz:
BEGIN;
SELECT balance FROM accounts WHERE id = 1;  -- 500
-- bu arada başka bir transaction commit etti
SELECT balance FROM accounts WHERE id = 1;  -- 300
COMMIT;
Her sorgu, o sorgunun başladığı andaki commit edilmiş veriyi görür. Transaction’ın başladığı anı değil.
Bir raporda önce toplamı, sonra detayları okuyorsanız, ikisi birbiriyle tutarsız olabilir. Toplam 1000 der, detayların toplamı 1200 eder.
Read-modify-write
Asıl tehlike şu kalıpta ortaya çıkar:
BEGIN;
SELECT stock FROM products WHERE id = 7;   -- 1
-- uygulama: stok varsa sat
UPDATE products SET stock = 0 WHERE id = 7;
INSERT INTO orders ...;
COMMIT;
İki transaction aynı anda çalışırsa ikisi de stoğu 1 olarak okur. İkisi de satış yapar. Tek ürün iki kez satılmış olur.
Transaction kullanılmış. Hatasız commit olmuş. Ama sonuç yanlış.
Read committed bu durumu engellemez. Bunu engellemek için ya satır okunurken kilitlenmeli:
SELECT stock FROM products WHERE id = 7 FOR UPDATE;ya da kontrol ve güncelleme tek bir atomik sorguda yapılmalı:
UPDATE products SET stock = stock - 1
WHERE id = 7 AND stock > 0;
Repeatable read
Bu seviyede transaction, başladığı andaki veritabanının bir anlık görüntüsünü görür. Aynı sorgu transaction boyunca hep aynı sonucu verir.
Rapor tutarsızlığı problemi çözülür.
PostgreSQL’de bu seviyede iki transaction aynı satırı güncellemeye çalışırsa ikincisi hata alır:
ERROR: could not serialize access due to concurrent updateBu bir bug değil, bir korumadır. Uygulamanın bu hatayı yakalayıp transaction’ı baştan denemesi gerekir.
Ama repeatable read bile her anomaliyi engellemez. Write skew denen durumda iki transaction farklı satırlara yazar, ama her biri diğerinin okuduğu veriye dayanarak karar vermiştir.
Klasik örnek: nöbetçi doktor sistemi. Kural “en az bir doktor nöbette olmalı”. İki doktor aynı anda nöbetten çıkmak ister. İkisi de diğerinin nöbette olduğunu görür ve kendi kaydını günceller. Sonuçta kimse nöbette kalmaz.
Serializable
En güçlü seviye. Sonuç, transaction’lar sırayla çalışmış gibi olmak zorundadır. Write skew dahil anomaliler engellenir.
PostgreSQL bunu kilitlerle değil, çakışmaları tespit ederek yapar. Çakışma olursa transaction’lardan biri serialization hatası alır ve tekrar denenmelidir.
Bedeli daha fazla retry ve bir miktar performans kaybıdır. Ama birçok uygulama için tahmin edildiği kadar yüksek değildir. Kritik işlemler için doğru seviyeyi seçmek, her yere manuel kilit eklemekten daha güvenli olabilir.
Pratikte ne yapıyorum?
Varsayılan read committed ile çalışıp kritik noktalarda açık kararlar veriyorum:
- Okuyup sonra yazan iş mantığında ya
FOR UPDATEya da atomik güncelleme. - Tutarlı görüntü gereken raporlarda repeatable read.
- Kuralları birden fazla satıra yayılan ve hata maliyeti yüksek işlemlerde serializable ve retry.
Ve en önemlisi, hangi seviyede çalıştığımızı bilmek.
Transaction kullanmak güvenli olduğumuz hissini veriyor.
Ama hangi garantiyi aldığımızı bilmeden kullanılan transaction, sadece daha düzenli görünen bir race condition.