
Production’da şu hatayı gördüğünüzü düşünün:
Connection is not available,
request timed out after 30000ms
En doğal tepki şudur: pool küçük kalmış, büyütelim.
spring.datasource.hikari.maximum-pool-size=100Deploy edersiniz.
Birkaç gün sonra aynı hata geri gelir. Üstelik bu sefer veritabanı CPU’su da yüksektir.
Veritabanı sonsuz paralel çalışmaz
Bir veritabanı sunucusunun belirli sayıda CPU core’u ve disk kapasitesi vardır.
8 core’lu bir makinede aynı anda 200 sorgu aktif olduğunda bu sorgular gerçekten paralel çalışmaz. İşletim sistemi onları sırayla çalıştırır, aralarında context switch yapar, lock’lar için bekletir.
Bir noktadan sonra eklenen her connection toplam throughput’u artırmaz. Tam tersine, bekleme ve çakışma maliyetini artırır.
HikariCP’nin pool sizing üzerine yazdığı not bu yüzden çok bilinir. Oradaki temel fikir şu: küçük bir pool ve önünde bekleyen bir kuyruk, büyük bir pool’dan genellikle daha iyi performans verir.
Başlangıç noktası olarak verilen formül de oldukça mütevazıdır:
connections = (core_count * 2) + effective_spindle_countBu formül kesin bir kural değil. Ama 8 core’lu bir PostgreSQL için 100 connection’ın neden şüpheli olduğunu anlatmaya yeter.
Asıl hesap instance sayısıyla yapılır
Pool boyutu tek uygulama için düşünüldüğünde makul görünebilir.
Ama uygulama tek başına çalışmıyor.
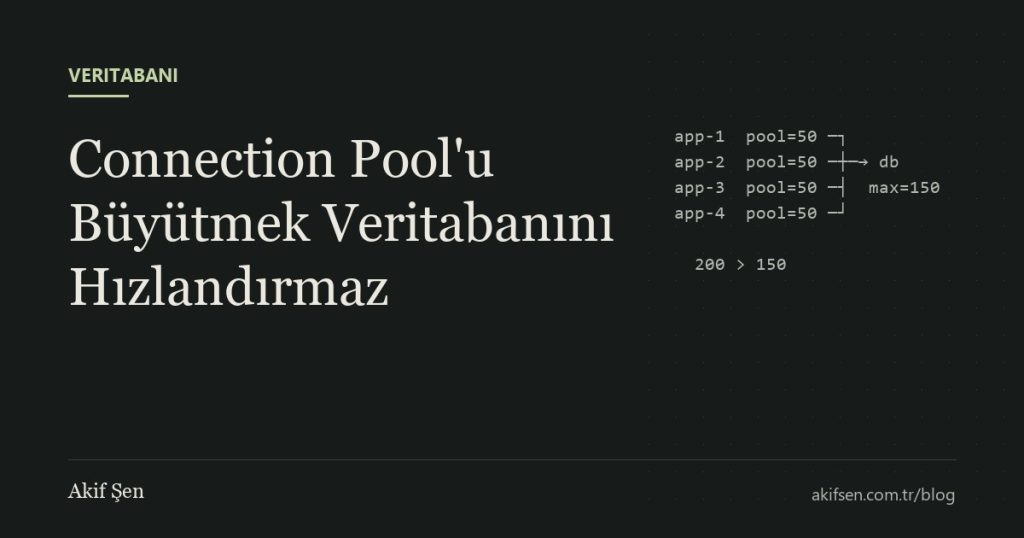
4 instance × 50 connection = 200Autoscaling devreye girip instance sayısı 8’e çıktığında bu sayı 400 olur. PostgreSQL’in varsayılan max_connections değeri ise 100’dür.
Yük arttığında sistem ölçeklenmeye çalışır, yeni instance’lar connection açamaz ve hata vermeye başlar. Kapasite eklemek sistemi daha kırılgan hale getirir.
Bu yüzden pool boyutunu belirlerken soru “bu uygulamaya kaç connection lazım?” değil, “veritabanı toplamda kaç aktif sorguyu verimli çalıştırabilir ve bunu instance’lar arasında nasıl paylaştırırız?” olmalıdır.
Çok sayıda instance varsa PgBouncer gibi bir connection pooler araya girer. Uygulamalar binlerce hafif connection açabilir, veritabanına ise sınırlı sayıda gerçek connection gider.
Timeout genellikle semptomdur
Pool’dan connection alamamak çoğu zaman pool’un küçük olduğunu göstermez.
Connection’ların uzun süre geri verilmediğini gösterir.
En sık gördüğüm sebepler:
- Transaction içinde HTTP çağrısı yapmak
- Yavaş bir sorgunun index olmadan full scan yapması
@Transactionalmetodun gereğinden büyük bir iş kapsaması- Connection leak, yani kapatılmayan connection
Bir transaction’ın içinde 3 saniyelik bir ödeme servisi çağrısı varsa, o connection 3 saniye boyunca hiçbir şey yapmadan bekler. Pool’u ikiye katlamak bu problemi çözmez, sadece biraz erteler.
Önce ölçmek
HikariCP metriklerinde bakılması gereken birkaç değer var:
hikaricp_connections_active
hikaricp_connections_pending
hikaricp_connections_usage_seconds
hikaricp_connections_acquire_seconds
usage süresi uzunsa sorun connection’ı tutan koddadır.
pending sürekli yüksekse ve usage kısaysa, gerçekten daha fazla connection gerekebilir.
Leak şüphesi varsa leakDetectionThreshold geçici olarak açılabilir. Belirtilen süreden uzun tutulan connection’lar için stack trace loglanır ve suçlu genellikle hemen bulunur.
Pool boyutu bir performans ayarı gibi görünse de aslında bir kapasite kararıdır.
Ve kapasite kararları tek bir servisin konfigürasyon dosyasında değil, sistemin bütününe bakılarak verilmelidir.