
Yavaş bir sorgu fark edildiğinde ilk yapılan şey genellikle şudur:
Sorgudaki kolonlara bakılır.
Her birine index eklenir.
CREATE INDEX idx_orders_tenant ON orders (tenant_id);
CREATE INDEX idx_orders_status ON orders (status);
CREATE INDEX idx_orders_created ON orders (created_at);
Üç index.
Sorgu yine yavaş.
Veritabanı genellikle tek index seçer
Şu sorguyu düşünelim:
SELECT * FROM orders
WHERE tenant_id = 42
  AND status = 'PENDING'
ORDER BY created_at DESC
LIMIT 20;
Üç ayrı index olduğunda planner çoğu zaman bunlardan birini seçer. Diyelim ki tenant_id index’i. O tenant’ın bütün siparişlerini bulur, sonra status koşulunu satır satır kontrol eder, sonra sonucu sıralar.
Tenant’ın 2 milyon siparişi varsa ve bunların 30 tanesi PENDING ise, veritabanı 30 satır için 2 milyon satırı gezer.
PostgreSQL bazı durumlarda bitmap scan ile birden fazla index’i birleştirebilir. Ama bu her zaman verimli değildir ve sıralama ihtiyacını karşılamaz.
Tek bir composite index
Aynı sorgu için daha doğru yapı şudur:
CREATE INDEX idx_orders_tenant_status_created
ON orders (tenant_id, status, created_at DESC);
Veritabanı index’te doğrudan tenant_id = 42 ve status = 'PENDING' olan bölüme gider. O bölümdeki kayıtlar zaten created_at sırasındadır. İlk 20 satırı okur ve durur.
Ayrı bir sıralama adımı yok. Gereksiz satır okuma yok.
Soldan sağa kuralı
Composite index bir telefon rehberi gibi çalışır. Önce soyadına, sonra ada göre sıralıdır.
Soyadı bilinirse arama hızlıdır. Soyadı ve ad bilinirse daha da hızlıdır. Ama sadece ad biliniyorsa rehberin tamamını taramak gerekir.
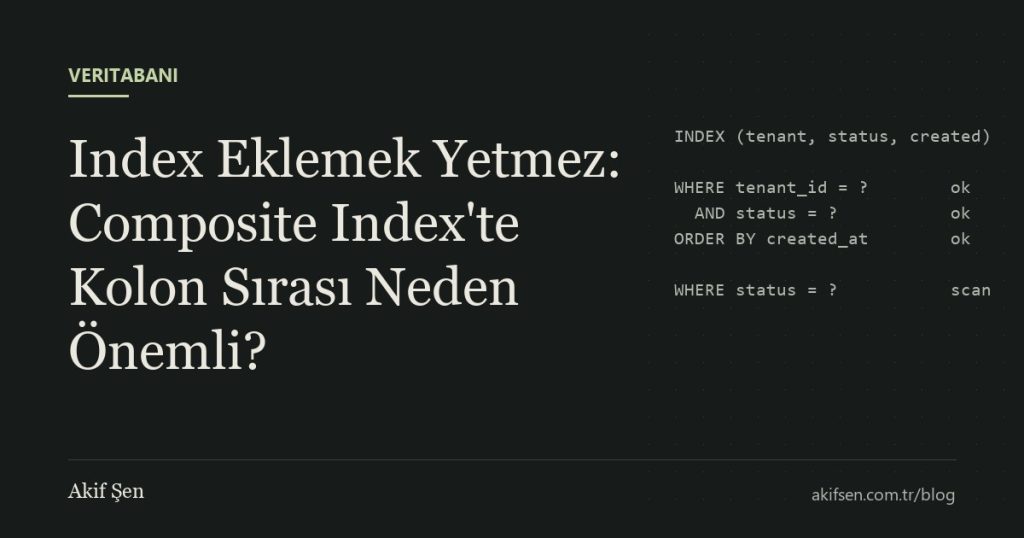
Index’te de aynı şey geçerli. (tenant_id, status, created_at) index’i şu sorgularda kullanılabilir:
WHERE tenant_id = ?
WHERE tenant_id = ? AND status = ?
WHERE tenant_id = ? AND status = ? ORDER BY created_at
Ama sadece status ile filtreleyen bir sorgu bu index’ten verimli şekilde faydalanamaz.
Kolon sırası nasıl seçilir?
Benim kullandığım basit bir sıra var:
Önce eşitlik koşulları. = ile filtrelenen kolonlar başa gelir.
Sonra sıralama veya aralık. ORDER BY ya da >, <, BETWEEN ile kullanılan kolon sona gelir.
Aralık koşulundan sonra gelen kolonlar index üzerinde aynı verimlilikle kullanılamaz. Bu yüzden created_at > ? gibi bir koşul genellikle index’in son kolonu olmalıdır.
Eşitlik kolonları arasında sıralama yaparken sık önerilen kural “en seçici kolon başa” kuralıdır. Ama multi-tenant sistemlerde tenant_id neredeyse her sorguda bulunduğu için, seçiciliği düşük olsa bile başa koymak çoğu zaman daha mantıklıdır. Bir index’in kaç farklı sorguya hizmet edebildiği de en az seçicilik kadar önemli.
EXPLAIN okumak
Tahmin etmek yerine ölçmek gerekir:
EXPLAIN (ANALYZE, BUFFERS)
SELECT ...
Bakılacak birkaç şey:
Seq Scanbüyük bir tabloda görünüyorsa index kullanılmıyor demektir.Rows Removed by Filterdeğeri yüksekse index doğru bölüme gitmiyor, gereksiz satırlar okunuyor demektir.- Plan’da ayrı bir
Sortadımı varsa index sıralama ihtiyacını karşılamıyor demektir.
Planner’ın tahmin ettiği satır sayısı ile gerçek satır sayısı arasında büyük fark varsa, istatistikler güncel olmayabilir. ANALYZE çalıştırmak bazen tek başına planı değiştirir.
Her index bir maliyettir
Index okumayı hızlandırır ama yazmayı yavaşlatır. Her INSERT ve UPDATE, ilgili bütün index’lerin de güncellenmesi demektir.
Yukarıdaki üç tekli index’i tek bir composite index ile değiştirmek hem okumayı hızlandırır hem de yazma maliyetini düşürür.
PostgreSQL’de pg_stat_user_indexes görünümü hangi index’lerin hiç kullanılmadığını gösterir. Yıllar içinde biriken ve hiçbir sorgunun kullanmadığı index’leri temizlemek, yazma ağırlıklı tablolarda fark edilir bir iyileşme sağlayabilir.
Index tasarımı kolonlardan değil, sorgulardan başlar.
Doğru soru “hangi kolona index ekleyelim?” değil, “bu sorgu veriye hangi yoldan ulaşmalı?” sorusu.